文鉴智检平台核心技术解读(2)-关键信息抽取
一、研究背景
信息抽取(IE)是自然语言处理的基础核心任务,旨在从无结构文本中抽取实体、关系、事件等结构化知识,细分包含命名实体识别 NER、关系抽取 RE、事件抽取 EE、面向属性情感分析 ABSA 等任务,同时文本阅读理解 MRC、文本分类也属于结构化语义解析范畴。长期以来,各类任务数据标注格式、建模目标完全独立,模型无法跨任务迁移共享知识,落地复杂业务时需要分别训练多个模型,带来巨大的训练、推理与维护成本。
苏州大学 NLP 课题组自研的文鉴智检平台,正是这类多任务文档处理系统的典型落地场景,平台需要依托信息抽取技术自动提取论文作者、参考文献、实验指标、学术事件等多元结构化要素,支撑格式校验、内容挖掘与合规审查全流程。平台业务同时涵盖实体识别、关系抽取、文本分类等多类抽取需求,传统分立模型部署方案会大幅拉高平台算力开销与维护成本,亟需一套统一、高效、适配复杂学术文本的通用抽取方案。而现有通用抽取技术要么推理缓慢、无法精确定位文本片段,要么功能覆盖范围有限,难以满足文鉴智检平台一站式文档解析的工程需求。
当前学界主流的通用信息抽取方案分为两大技术路线,但均存在明显短板。第一条是生成式预训练模型路线,代表工作有 UIE、TANL、DeepStruct、InstructUIE,以 T5、GLM、FlanT5 等 seq2seq 模型为底座,将抽取任务转化为文本生成任务。该类方案通过线性化 schema 指令实现多任务统一,但存在三大硬伤:一是依靠字符串匹配定位文本片段,存在严重歧义,无法输出 token 精确位置,影响评测与业务过滤;二是自回归逐 token 生成推理速度极慢,大参数量模型算力消耗巨大;三是原生不支持非连续实体、n 元多元组抽取等复杂场景。
第二条路线是抽取式统一匹配模型,以 USM 为代表,基于 BERT 类编码器 + 语义匹配预测三元组。这类模型推理速度更快、可输出精确位置,但功能边界狭窄,仅能处理简单三元组任务,无法兼容多跨度实体、超关系抽取,更不能拓展至阅读理解与分类任务。
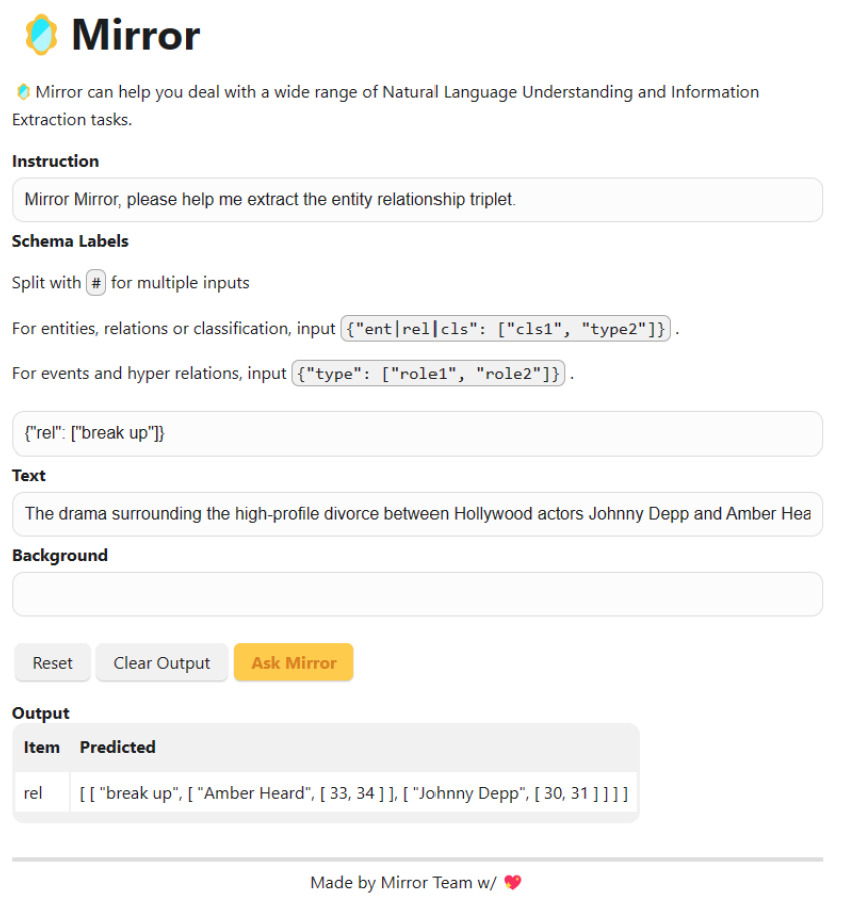
针对通用性、定位准确性、推理效率三者无法兼顾的行业痛点,苏州大学人工智能学院联合华为云在 EMNLP 2023 提出Mirror通用抽取框架。框架名称源自《白雪公主》中的魔镜,寓意一套模型即可统一处理全部语义抽取与理解任务。
二、核心技术设计:三层统一范式实现全任务兼容
2.1 标准化统一输入接口
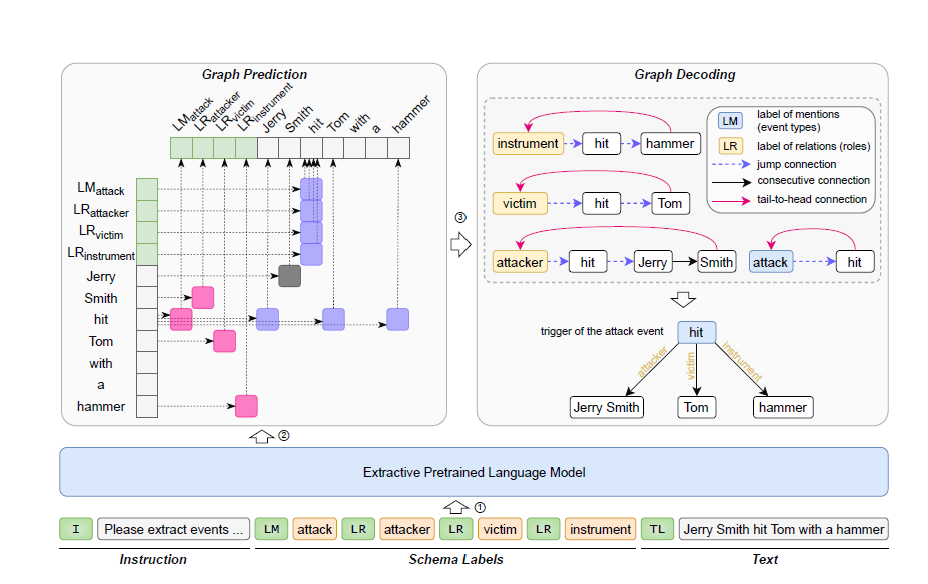
Mirror 设计了三段式通用输入模板,依靠专属分隔标记统一 8 大类任务输入格式,是实现多任务共享底座的基础:
1. 指令段[I]:自然语言描述任务需求,MRC 任务直接以问题作为指令;
2. Schema 标签段:通过[LM]实体标签、[LR]关系 / 论元标签、[LC]分类标签承载任务模式;
3. 文本段:区分[TL]抽取文本、[TP]无 schema 问答文本、[B]分类背景文本。
该输入范式天然适配指令微调,仅更换指令与 schema 即可完成少样本、零样本迁移,无需改动模型结构。团队人工整理 57 个跨任务数据集构建预训练语料,总样本超 51 万,覆盖 NER、关系、事件、分类、阅读理解五大类任务,平衡各类样本数量保障跨任务均衡学习。
2.2 多槽元组 + 多跨度循环图统一建模
区别于传统三元组约束,Mirror 将所有抽取任务统一建模为可变长度多槽元组,三元组、四元组乃至多元超关系均可适配,彻底解决 n 元抽取难题。 为编码元组内文本片段的关联关系,论文提出多跨度循环图,图中包含三种核心连接边:
1. 连续边:连接同一实体内部多个 token,解决连续实体、长实体识别;
2. 跳跃边:连接元组不同槽位,建立标签与实体、实体与实体的跨位置关联;
3. 首尾闭环边:连接元组最后一个片段与首个标签,用于校验完整合法元组、过滤无效图路径。
模型选用 DeBERTa-v3-large 作为编码底座,通过双仿射注意力计算任意 token 间三类连接的概率,生成全局邻接矩阵;配套非自回归并行解码算法,单次前向传播即可预测全部实体、关系、事件论元的精确 token 位置,完全规避生成模型的匹配歧义问题。
2.3 模型训练与损失设计
编码器输出 token 表征后,两层前馈网络分别处理起点、终点表征,双仿射层预测三类边的连接概率;训练阶段采用不平衡多标签分类交叉熵损失,适配图中正负边样本极度不均衡的现实。推理时设置 0.5 阈值筛选有效连接,再通过循环图解码算法拆分出完整多槽元组。
三、实验结果:通用性、效率、少样本能力全面验证
3.1 多任务基准对比,唯一全覆盖通用框架
论文在 8 大类 30 个公开数据集完成评测,对比 TANL、UIE、USM、InstructUIE 等主流通用模型。从对比表格可见,现有通用模型均存在功能短板:生成式模型不支持精确位置索引、多跨度与 n 元抽取;USM 仅支持基础三元组。而 Mirror 是唯一同时支持多跨度实体、n 元超关系、MRC、文本分类的统一框架。 在常规 NER、RE、EE 任务上,Mirror 性能全面超越 TANL,多数数据集优于 UIE;对比 10B、11B 超大参数量 DeepStruct、InstructUIE,仅 434M 参数的 Mirror 达到接近甚至持平的效果;在超关系抽取任务上,Mirror 超越专用模型 CubeRE 取得 SOTA。3.2 少样本、零样本迁移能力
在 1/5/10 小样本场景下,预训练 + 指令微调的 Mirror 在 CoNLL03、ACE05 等 NER、事件抽取数据集上平均 F1 显著优于 USM、UIE;7 个域外零样本 NER 数据集测试中,Mirror 平均 F1 远超 USM,和 11B 参数 InstructUIE 差距极小,小参数量下零样本泛化能力极具优势。
3.3 推理速度大幅领先生成式模型
在单 V100 显卡下完成速度测试:批次为 1 时,Mirror 每秒处理样本数是 UIE 的 27.24 倍;批次为 2 时提速 32.61 倍。非自回归并行解码带来极致推理效率,更适合线上高并发工业场景。
3.4 消融实验验证各模块价值
1. 预训练消融:预训练语料中分类、抽取、阅读理解数据互相增益,分类数据集可显著提升关系抽取效果;
2. 标签形式消融:专用标记标签与文本字面标签效果接近,专用标记更适配无指令场景;
3. 预训练必要性:缺少预训练时少样本性能大幅下滑,预训练是零样本能力的核心保障。
四、技术总结
Mirror 突破了过往通用信息抽取 “生成式速度慢、抽取式功能弱” 的二元对立,以抽取式图结构为核心,通过统一输入范式、多跨度循环图建模,一套轻量级模型实现实体、关系、事件、情感分析、阅读理解、文本分类全任务覆盖,同时兼顾精确位置输出、高速推理、强大的少 / 零样本迁移能力。
论文开源完整代码、预训练权重与 57 数据集预训练语料,为学术界提供统一多任务研究基线,也为企业落地轻量化一站式文本结构化系统提供低成本可行方案,对通用信息抽取领域的技术落地与后续研究具有重要参考意义。该相关技术已经成功运用于文鉴智检平台(aiyu-tech.com),提高文档信息抽取的成功率,能解析国内学位论文模板规范(1000+以上高校)的毕业论文,支持论文自动检测与修正。
数据集与代码已在github开源https://github.com/Spico197/Mirror/,欢迎使用。